博文

目前显示的是标签为“Deepseek”的博文

DeepEP原理分析(二):low latency模式代码详解(更新中)

图片
最近在做基于 DeepEP 和 SGLang 的推理优化。DeepEP 是一个用于取代 MoE 模型中 AlltoAll 操作、非常精妙和细致的点对点通信 kernel,好好研读其实现过程对 CUDA 编程、MoE rank 间通信都有巨大好处(下面的分析基于0625 main版本,详细代码请自行上 github 上搜索) 1 dispatch 1.1 入参详解 1、接收与打包参数:主要用于在目标 GPU 上存储从其他 GPU 接收到的数据 - packed_recv_x:用于存储接收到的已打包好的 token 特征数据,这些数据将直接用于本地专家的计算。这是数据在接收方的最终存储位置 - packed_recv_x_scales:如果使用 FP8 量化传输,这个指针指向用于存储 packed_recv_x 对应 FP8 scale(缩放因子)的缓冲区 - packed_recv_src_info:存储每个接收到的 token 在其来源 GPU 上的原始索引 。这个信息在后续 combine 阶段至关重要,用于将计算结果正确地写回 - packed_recv_layout_range:记录由每个本地专家从各个源 rank 接收到的 token 的布局信息。它通常将来自某个源 rank 的 token 总数和 token 在 packed_recv_x 缓冲区中的起始偏移量打包成一个 64 位整数,其结构可参考下面这个二维数组示意图,这个结构使得 dispatch kernel 能够记录每个本地专家从哪个源 rank 接收了多少 token,以及这些 token 在接收缓冲区中的具体位置。随后 combine kernel 可以利用这些信息,将处理后的 token 结果正确地发送回它们最初的源 rank - packed_recv_count:原子计数器,每个本地专家都有一个属于自己的该计数器,用来追踪该专家已经接收了多少 token,以便为新到达的 token 计算正确的存储偏移量 - cumulative_local_expert_recv_stats:用于累计每个本地专家接收到的 token 总数,作为统计信息 2、RDMA 缓冲区参数:RDMA 通信过程所需的空间和信号 - rdma_recv_x:RDMA 接收缓冲区。从其他节点通过网络发送过来的数据会先被存...

Deepseek DualPipe 分析

图片
一、DualPipe 特点 1、计算和通信 overlap(下图为由 forward chunk 和 backward chunk 组成的 chunk 对的计算和通信流程) 每个 chunk 均会经历四个过程:attention、all-to-all dispatch、MLP 以及 all-to-all combine。橙色表示 forward,绿色表示 input 的 backward,蓝色表示 weight 的 backward,紫色表示 PP 通信,红色表示 barrier 从下面第一张图可以看出, PP 和 alltoall 的通信过程被隐藏在 MLP 和 attention 的计算过程中 从下面第二张图可以看出,DualPipe 使用了 bidirectional pipeline scheduling ,即同时向流水线的首位两端传入 micro-batch 从而充分利用硬件资源  不同 PP 策略对应的 bubbles 数量和 memory usage 的对比 2、 all-to -all communication 优化 定制化 kernels :设计过程结合了 MoE gating algorithm 和集群的 network topology IB 和 NVLink 的 overlapping :每个 token 最多只会被分配到 4 个不同节点 上来减少 IB 流量,同时在分配 token 时让 IB 和 NVLink 的带宽充分 overlap,从而在不引入 NVLink 通信 overhead 的情况下使得某个节点上的 token 有能力选择 3.2 个 experts(即最多支持 4x3.2=13 experts,DS-v3 限制在 8 experts) SM 动态分配 :将 20 个 SMs 动态分配到 10 个 communication channels 上。具体来说 Dispatch 过程:IB sending、IB-to-NVLink forwarding、NVLink receiving 三个过程分别使用不同的 warps Combine 过程:NVLink sending、 NVLink-to-IB forwarding&accumulation、IB receiving&accumulati...

Zero Bubble 论文分析

图片
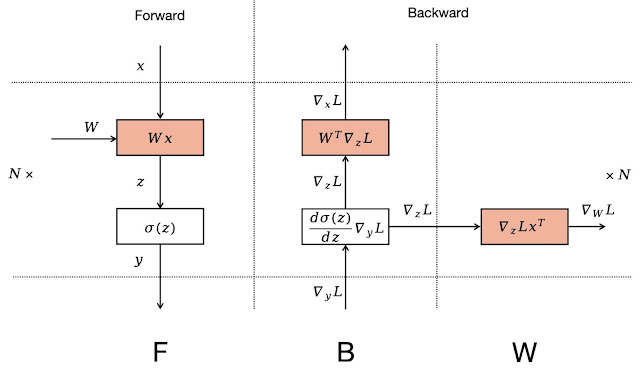
关键词:输入梯度,权重梯度,Pipeline Parallelism,Zero Bubble,1F1B 在 Deepseek-V3 technical report 中提到了一项很重要的训练优化技术:DualPipe,该技术的目的是为了尽可能地实现 computation 和 communication 两者的 overlapping,DS 作者提到 DualPipe 的设计参考了 ZeroBubble 策略,在 attention&MLP 梯度反向传播过程中区分 input backward 以及 weights backward。这一思想就是来源于 Zero Bubble 论文 ,这种细粒度梯度反向传播优化也让 Pipeline Parallelism 的效率得到了进一步的提升。 一、MLP 的反向传播过程 MLP(多层感知机)的反向传播过程可以分为两个部分: 输入梯度计算 (用 B 表示)和 权重梯度计算 (用 W 表示),前者为基于损失函数对上一层输出 x 进行微分后的结果,返回给上一层并用于该层的权重更新;后者用于本层权重的更新。 以往的设计中 B 和 W 被封装为同一个 backward function 提供给用户 ,这种设计对用户比较友好,且不会影响 DP 流程的效率(W 的通信和 B 的反向传播两者可以 overlap),但会影响 PP 流程的效率,因为上一层 B 的计算需要等待本层 W 计算完毕。因此 ZB 的做法是 splitting B & W 这两个流程。 二、ZB 涉及的 PP 流程和 1F1B 的区别 1、F 和 B 保持 sequentially dependent 的关系,但 W 可以灵活安排来尽可能让 W 的计算时间填补 pipeline bubbles 2、在假设 F/B/W 三个流程耗时均相同的情况下 1F1B、ZB-H1 和 ZB-H2 三者对比如下图所示 ZB-H1:Memory efficient schedule,B 先于 W 从而保证在 maximum peak memory usage 不超过 1F1B 的情况下 bubble size 减少为 1F1B 的三分之一 ZB-H2:Zero bubble schedule,在 warm-up 阶段引入更多的 micro-batches 来填补 ZB-...